全球首个!AI 能看 146 种病,中国团队登上 Science



一个 AI,开始尝试一次看懂整套腹部 CT。
9 月 17 日,阿里巴巴达摩院与浙江大学医学院附属第一医院研发的 DAMO RADAR 登上 Science,可覆盖 18 个解剖结构、146 项影像学异常和征象。
在一项由 26 名影像科医生参与的读片测试中,RADAR 的表现高于其中 23 人,约占 88%。
AI 开始「通读」腹部 CT,表现超过 88% 的医生
传统医疗影像 AI,大多采用「专病专模」。一个模型看肺结节,一个模型看胰腺癌,另一个模型看胃癌。任务越明确,模型越容易围绕一种疾病做到更高精度。
RADAR 不预先限定某一种疾病,而是按照腹部不同解剖区域逐一检查,再把局部影像与对应的医学报告内容进行匹配。
简单来说,模型学习的不只是「这一套 CT 最后诊断什么」,而是进一步判断哪个器官,出现了什么异常。
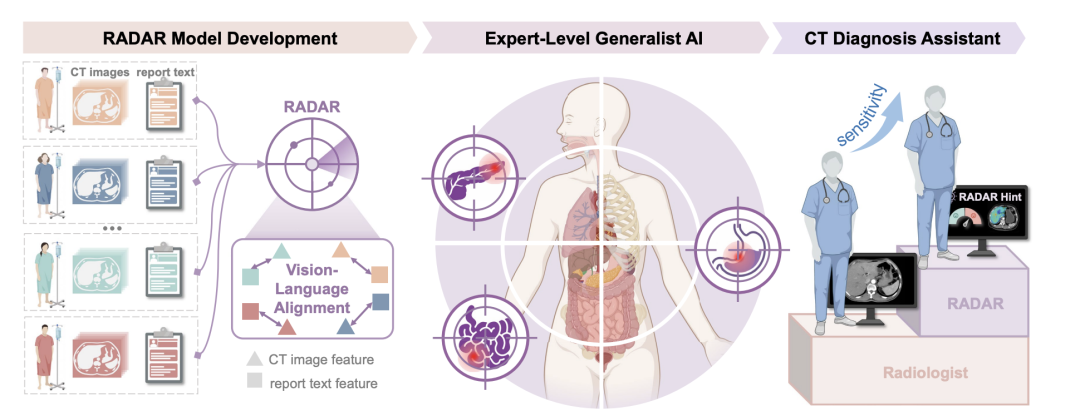
图源:Science
这种方法也减少了对逐病种人工标注的依赖。医院本身已经积累了大量 CT 影像和对应的影像报告,RADAR 可以直接利用这些临床数据,学习影像特征与医学描述之间的关系。
研究首先在 39,160 例内部真实世界病例中验证 RADAR,在 146 项影像学异常上,模型的平均 AUC 达到 0.913。
AUC 可以简单理解为模型区分「有异常」和「无异常」的能力。数值越接近 1,区分能力越强;0.5 接近随机判断,0.9 以上通常代表较强的鉴别能力。
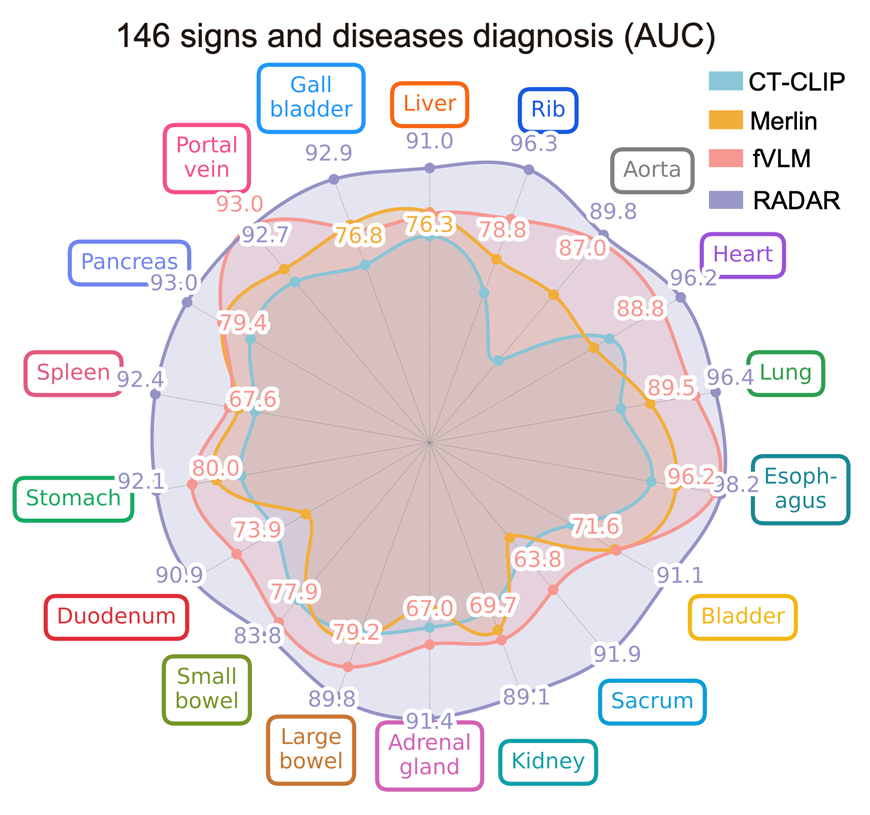
图源:Science
随后,研究人员又在 8 家外部医疗中心进行验证。不同中心覆盖 68~136 项异常,平均 AUC 约为 0.895。
研究还专门挑选了一批有手术或活检病理结果的病例——也就是以病理诊断作为最终判断标准。在肝细胞癌、胰腺癌、胃癌和结直肠癌等疾病中,RADAR 的 AUC 达到 0.891~0.984。
模型随后又被放进了急诊场景。
在 27,267 例急诊 CT 中,针对 17 种常见急腹症,RADAR 的平均 AUC 仍达到 0.904。
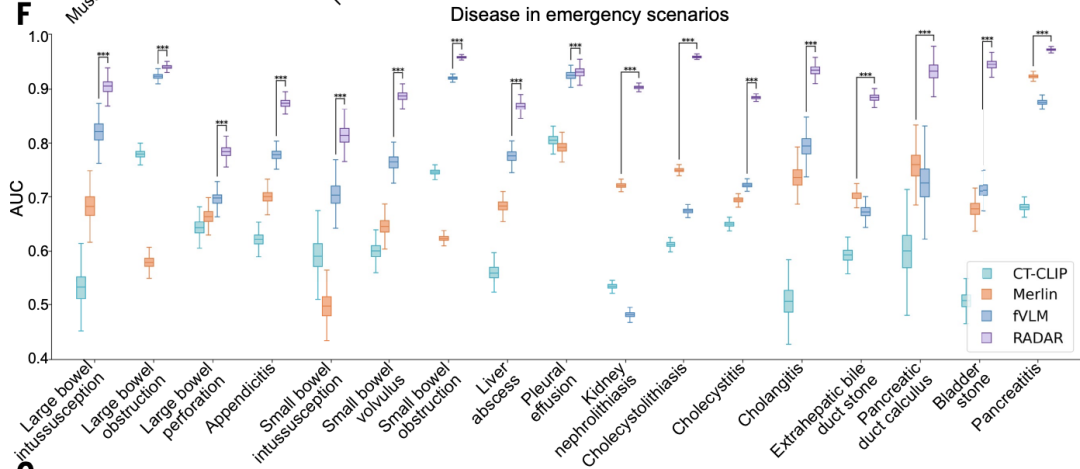
图源:Science
也就是说,换医院、换设备、换患者,甚至换到急诊这样的新场景后,模型仍保持了相对稳定的识别能力。
研究中最受关注的一部分,是 RADAR 与影像科医生的直接比较。
读片测试包含 300 例腹部增强 CT,也就是注射造影剂后进行的腹部 CT 检查,涉及 61 项影像学异常,以及来自 14 家医院的 26 名影像科医生。
结果显示,在这项受控读片实验中,RADAR 的整体表现高于其中 23 名医生,仅有 3 名资深医生表现更高。
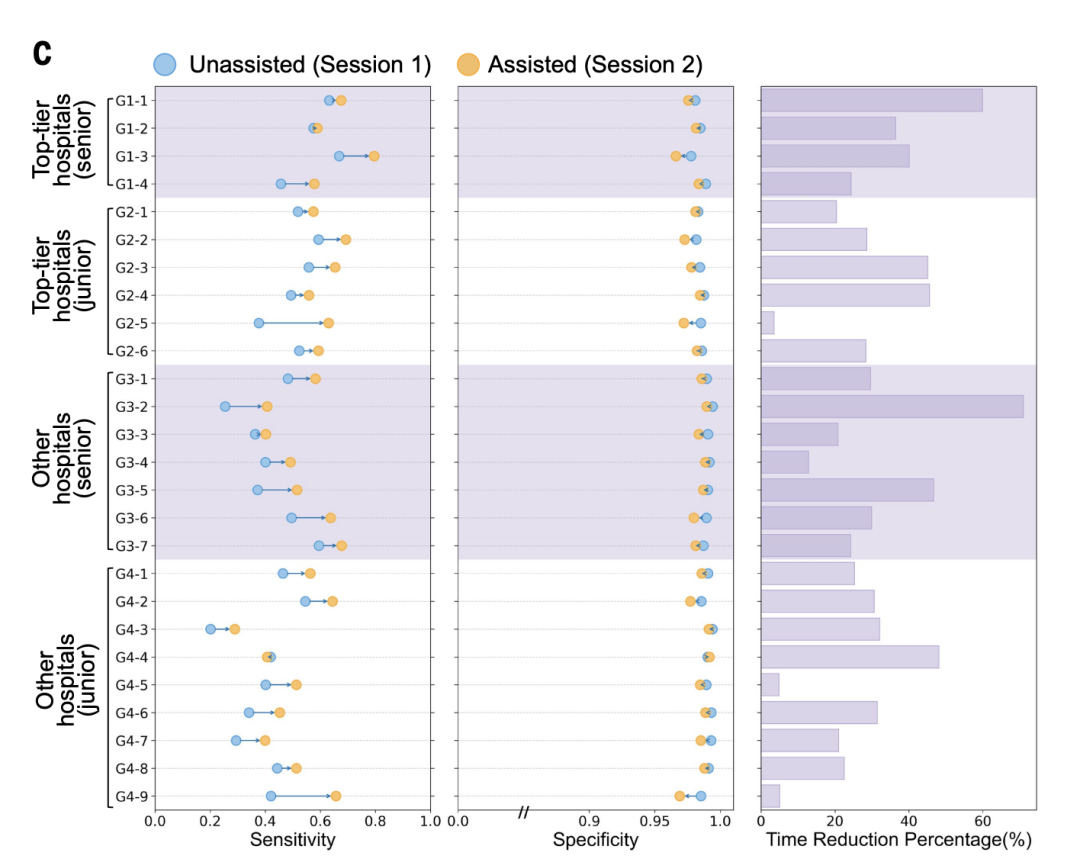
图源:Science
研究人员随后进一步测试,如果不是让 AI 和医生比赛,而是让医生使用 AI,会发生什么?
结果显示,使用 RADAR 后,医生识别异常的敏感性提高约 10 个百分点,平均阅片时间缩短 30.7%,但特异性有轻微下降。
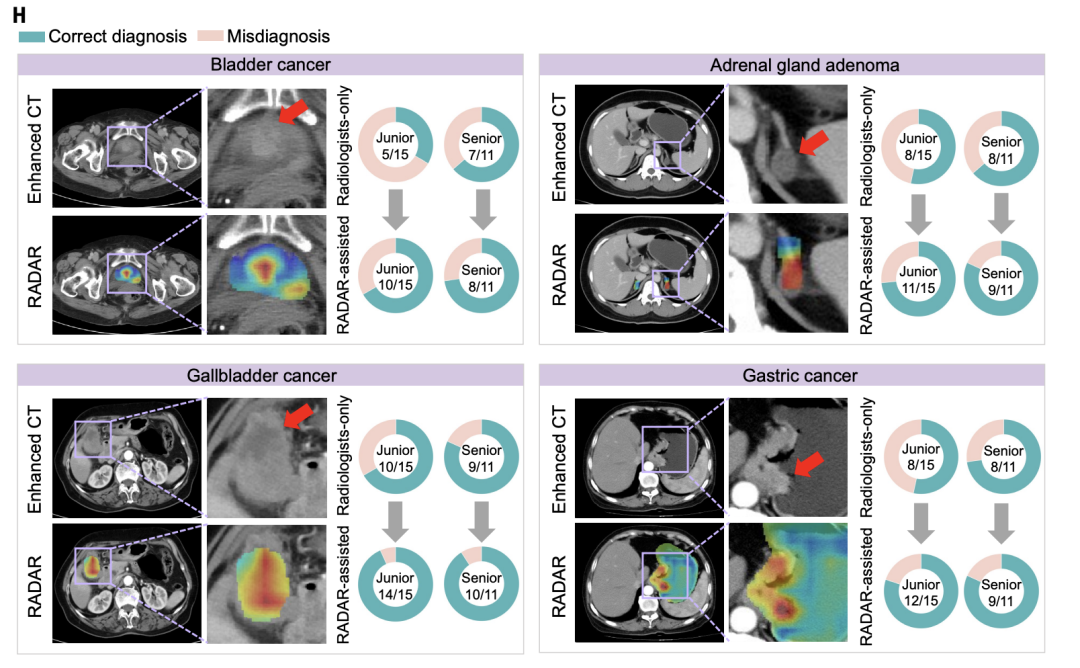
图源:Science
这里的「敏感性」,可以理解为发现真正异常、减少漏诊的能力;「特异性」则是正确判断正常、减少误报的能力。
换句话说,RADAR 帮助医生发现了更多原本可能遗漏的异常,也明显缩短了阅片时间,但代价是会多提示少量最终并不存在的异常。
因此,目前 RADAR 更适合被理解为一个「第二阅片者」,先系统扫描整套影像,提示医生可能遗漏的位置,再由医生完成最终判断。
不过,这项研究的主要证据仍来自回顾性多中心验证和受控读片实验。真正部署到医院后,它能否持续减少漏诊、提高效率,以及会不会带来过多误报,仍需要前瞻性临床研究进一步验证。
一个病一个 AI,什么时候才能做完?
RADAR 不是达摩院突然做出来的。
过去几年,这支团队一直在做同一件事,从患者已经拍好的 CT 中,再找出原本可能被忽略的疾病信息。
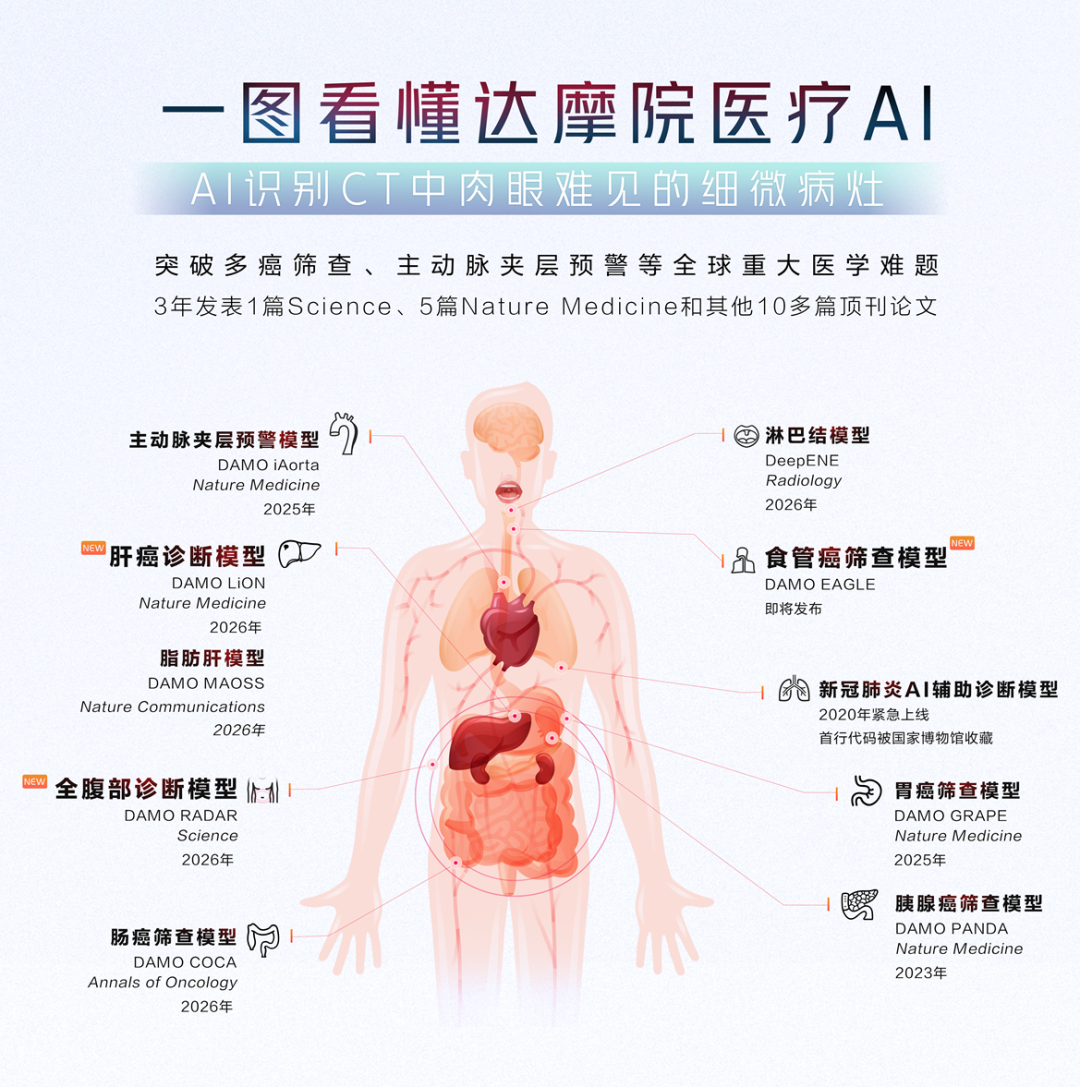
2023 年,胰腺癌模型 PANDA 发表于 Nature Medicine。在 20,530 人的真实世界回顾性验证中,PANDA 从普通平扫 CT 中发现了 31 个此前诊疗流程未识别的胰腺病变,其中包括 5 例癌症。
这条路线的核心,是不增加新的检查,而是重新利用已经存在的 CT。
2025 年,DAMO GRAPE 同样发表于 Nature Medicine,将这一思路扩展到胃癌,尝试从原本并非用于胃癌筛查的平扫 CT 中识别高风险患者。
图源:Nature Medicine
2026 年,DAMO COCA 发表于 Annals of Oncology。在两个真实世界队列、共 27,433 人中,模型发现了 5 例此前诊疗流程遗漏的结直肠癌。
图源:Annals of Oncology
同年 8 月,达摩院联合中国医科大学附属盛京医院等机构研发的肝脏恶性肿瘤诊断模型 DAMO LiON 再次登上 Nature Medicine,面向增强 CT 识别肝脏恶性病变。
图源:Nature Medicine
这些模型有一个共同点,不增加新的检查,而是重新利用已经存在的 CT。
但「专病专模」也有明显局限。每增加一种疾病,都要重新收集病例、标注数据、训练模型,再完成内部和外部验证。
达摩院高级算法专家张建鹏因此提出过一个问题:「按照这个速度,是不是一辈子都做不完?」
图源:达摩院
RADAR 正是在这个背景下出现的。
过去,模型回答的是「这张 CT 里有没有某一种癌症」;现在,RADAR 要回答的是「这套腹部 CT 里,哪些器官出现了哪些异常」。
变化的不是病种数量,而是模型要解决的问题变了,从识别一种疾病,走向系统读取整套影像。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”